ИИ-новости · Вдвоём
Anthropic собрала линейку Claude 5.5 за две недели. Что дают Sonnet 5.5 и Haiku 5.5
Средняя модель обогнала флагмана в тесте на программирование, а младшая подешевела в десять раз и сравнялась по цене с GPT-6 Luna. Разбираем цифры и решаем, какую модель брать под какую задачу.
С 22 сентября по 7 октября 2026 года Anthropic выпустила всю линейку Claude 5.5: сначала флагманскую Opus 5.5, через шесть дней Sonnet 5.5, а 7 октября младшую Haiku 5.5. Про Opus 5.5 мы уже писали отдельно. Сегодня про две другие модели, потому что для большинства реальных задач именно они важнее флагмана: на них держится повседневная работа, где нужны скорость и низкая цена. Разбираем, что нового, какие цифры стоит читать внимательно и как выбрать модель под задачу.
Что реально нового
Sonnet 5.5: быстрее и дешевле на задачу при той же цене. Модель стоит те же 2 доллара за миллион входных токенов и 10 за миллион выходных, что и Sonnet 5. По данным Anthropic, она работает больше чем на 30 процентов быстрее и обходится до 30 процентов дешевле на одну задачу, потому что тратит меньше токенов и действий. Первые клиенты называют свои цифры: у Box ответы стали в 2,4 раза быстрее, у Slack на 14 процентов меньше выходных токенов, у Lovable на треть меньше вызовов инструментов при работе с кодом.
Sonnet 5.5 обогнала флагмана в программировании. В тесте Terminal-Bench 4.0, где модель сама выполняет задачи в командной строке, Sonnet 5.5 набрала 70,6 процента. Для сравнения, Opus 5.5 в том же тесте, по данным Anthropic, показала 66,4 процента. Средняя модель впереди старшей, по крайней мере в этом тесте.
Haiku 5.5: цена упала в десять раз. Для запросов до 100 тысяч токенов она стоит 10 центов за миллион входных токенов и 50 центов за миллион выходных, это на 90 процентов дешевле прошлой Haiku 4.5. С учётом реальных размеров запросов Anthropic оценивает экономию примерно в 75 процентов. Контекст вырос до миллиона токенов, а длина ответа до 128 тысяч. Цена в точности совпадает с GPT-6 Luna от OpenAI.
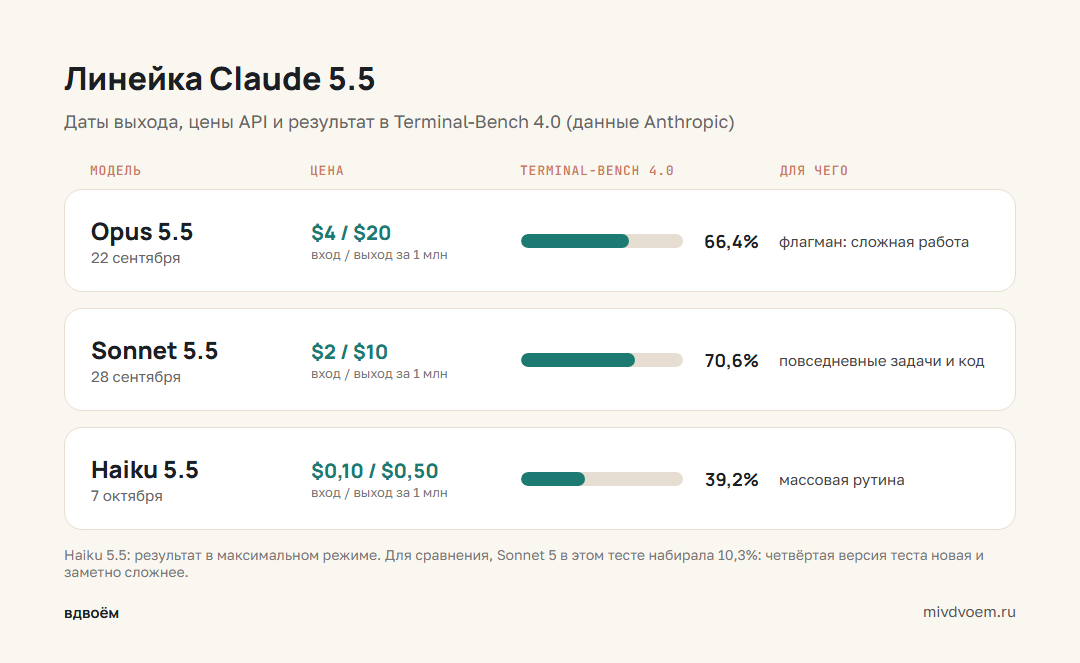
Линейка Claude 5.5: даты выхода, цены и результаты в тесте на программирование
Какие цифры стоит читать внимательно
Самая громкая цифра релиза звучит так: Sonnet 5 в том же Terminal-Bench 4.0 набирала всего 10,3 процента, то есть рост в семь раз. Выглядит как чудо, но объяснение скромнее: четвёртая версия теста новая и заметно сложнее прошлых, и старые модели на ней почти не справляются. Рост настоящий, но сравнивать 10 и 70 процентов как «стала в семь раз умнее» неправильно.
Второй момент: почти все цифры в анонсах дала сама Anthropic. Независимых замеров пока мало, и они обычно получаются чуть ниже заявленных, как это было с Opus 5.5. И ещё одна деталь: у Haiku 5.5 тот же тест в максимальном режиме даёт 39,2 процента, а в среднем режиме около 20. Младшая модель хороша для объёмной простой работы, но сложное программирование ей лучше не отдавать.
Почему это важно не только разработчикам
Линейка из трёх моделей нужна, чтобы платить за интеллект ровно столько, сколько требует задача. Сложное и важное отдаёте флагману, повседневную работу средней модели, а массовую рутину младшей. Когда младшая стоит 10 центов за миллион токенов, автоматизировать разбор писем, заявок и документов становится почти бесплатно даже для очень маленького бизнеса.
Живой пример: как это выглядит у нас
В проекте «Вдвоём» вся основная работа идёт в агентных сессиях Claude: на нём собраны бот с приёмом оплаты, четыре PDF-модуля курса и монтаж роликов для ИИ-блогера Насти. Агент сам ведёт задачу от постановки до проверки результата.
На практике у нас тоже разные уровни задач. Писать код бота и собирать видео нужно сильной модели. А, например, каждую неделю мы просматриваем десятки новостей про ИИ, чтобы отобрать свежие и проверить, не выходили ли они у нас раньше. Это объёмная однотипная работа, и именно под такие задачи сделаны модели вроде Haiku 5.5: быстро, дёшево и достаточно аккуратно, если человек проверяет итог.
Что с этим делать
- Не берите самую мощную модель «на всякий случай». Для большинства задач Sonnet 5.5 хватает, а по программированию она даже не уступает флагману.
- Вынесите массовую рутину на младшую модель. Пересказы, сортировка, извлечение данных из документов с Haiku 5.5 стоят копейки.
- Сверяйте цифры из анонсов с реальной работой. Новые тесты бывают сложнее старых, а независимые замеры часто скромнее рекламных.
Какие задачи уже можно отдать ИИ?
Начните с бота «Вдвоём»: подскажем, с чего начать именно в вашем деле. А как мы сами работаем с ИИ, рассказываем на mivdvoem.ru.
Написать в бота →Источники: анонсы Anthropic о Claude Sonnet 5.5 (28 сентября 2026) и Claude Haiku 5.5 (7 октября 2026), VentureBeat, MarkTechPost, DataNorth.